最便宜的云区域,往往离你的用户最远
同一台云服务器,价格一动不动,从东京到圣保罗体验差 2.3 倍。价格、时延、地理位置,三个维度都对,答案才敢上线。
周一早上,两张表同时摆在你面前。
一张来自 FinOps:全球 233 个云区域里,2 vCPU / 4 GiB 的最低月成本是 $5.55。 另一张来自 SRE:离用户最近的区域,平均时延 11.0 ms。
两个数字都很漂亮,但它们指向两个相距 8000 公里的地方。
这不是谁算错了。这是两个不同的问题,被塞进了同一场会议。
一句话结论: 价格表里没有「用户」这一列。最低价回答的是「哪里卖得最便宜」,而你要回答的是「我的用户从哪条路进来」。同一台机器,价格一动不动,体验能差 2.3 倍——差的就是这一段距离。
下面按三个维度逐层拆:价格(第一节)、时延(第二、三节)、地理(第四节)。拆到最后你会发现,这三个维度收成了同一个问题——你的用户在哪。
一、价格:最低价买到的,可能是另一种东西
1. 同一台机器,跨区域价差 2.4 倍
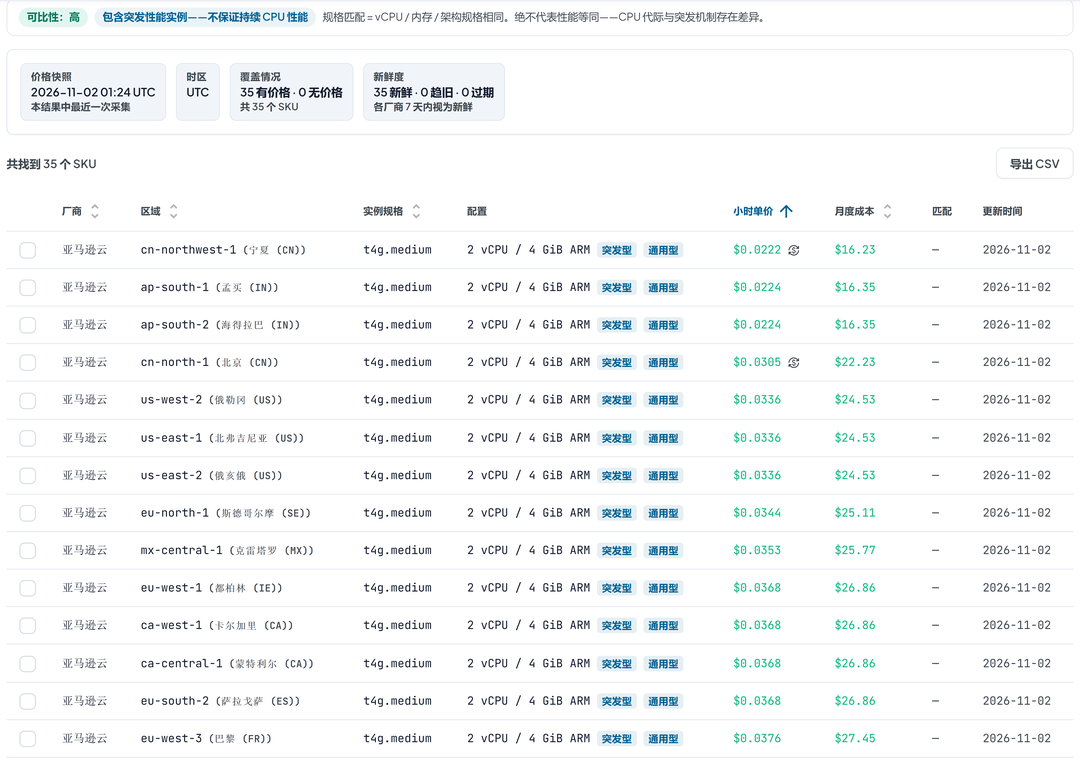
Amazon EC2 t4g.medium,2 vCPU / 4 GiB / ARM / Linux / 按量付费。同一个实例型号,同一个官方价格 API 里拉出来的两行:
| 区域 | 小时单价 | 月度成本(730h) |
|---|---|---|
| 宁夏(cn-northwest-1) | $0.0222 | $16.23 |
| 孟买 / 海得拉巴(IN) | $0.0224 | $16.35 |
| 北弗吉尼亚(us-east-1) | $0.0336 | $24.53 |
| 法兰克福(eu-central-1) | $0.0384 | $28.03 |
| 圣保罗(sa-east-1) | $0.0536 | $39.13 |
2.4 倍。 不是不同代际,不是不同规格,是同一行 SKU 换了个经纬度。
所以「哪个区域最便宜」这个问题,答案会随着你手里的规格清单一起变。你还没走到时延那一步,价格本身就已经不是单值了。
2. 同一座城市,四家云价差 2 倍
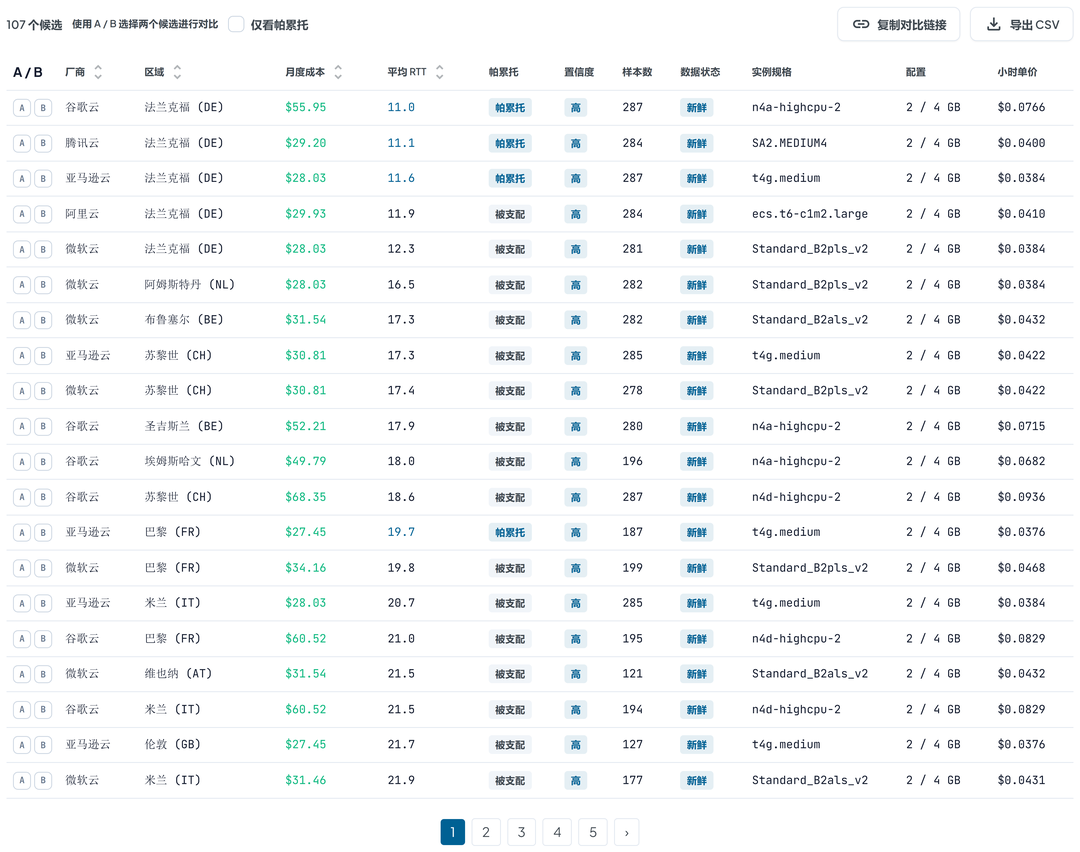
再看横切面。把来源国家设成德国,规格固定 2 vCPU / 4 GiB / Linux,看法兰克福这一座城市:
| 云厂商 | 实例 | 月度成本 | 平均 RTT | 帕累托状态 |
|---|---|---|---|---|
| 亚马逊云 | t4g.medium | $28.03 | 11.6 ms | 帕累托 |
| 腾讯云 | SA2.MEDIUM4 | $29.20 | 11.1 ms | 帕累托 |
| 阿里云 | ecs.t6-c1m2.large | $29.93 | 11.9 ms | 被支配 |
| 微软云 | Standard_B2pls_v2 | $28.03 | 12.3 ms | 被支配 |
| 谷歌云 | n4a-highcpu-2 | $55.95 | 11.0 ms | 帕累托 |
谷歌云贵 2 倍,快 1.3 毫秒。
物理上这是合理的——法兰克福同一座城,光纤路径差不了几公里,能差的只有接入方式、对等互联质量和最后一跳的拥塞。但你得自己判断:这 1.3 毫秒,对你的业务值 $27.92 一个月吗?
对高频交易值。对一个日活五万的 B 端 SaaS,大概率不值。
3. 最低价的 SKU,几乎都是「另一种 CPU」
这是最容易被忽略的一层。
上一张表里,$28.03 的 t4g.medium 是突发型;$55.95 的 n4a-highcpu-2 是独享型。它们都叫「2 vCPU / 4 GiB」,但持续算力差着一个量级。
PingCloud 全球最低价那一档——华为云 at7.large.2($5.55)、t7.large.2($7.01)、腾讯云 BF1.MEDIUM4、微软 B 系列——全部是突发型或共享型。
规格匹配(Spec Match)只承诺三件事:vCPU 数、内存 GiB、CPU 架构一致。它从不承诺性能。持续高负载跑满 CPU 积分之后,突发型会掉到基线,那时你的「便宜」就变成了「慢」。
PingCloud 的处理方式是给每一条对比打上「可比性:高 / 中 / 低」标签,并且在探索器里,当筛选集合混入不同架构、突发类型或实例规格时,直接弹出一条警告:混合性能前沿——意思是这些点之间的权衡,不是同等条件下的权衡。
这是产品设计里我很喜欢的一个克制:不假装所有 2C4G 是一回事。
4. 还有一层:目录价不是你的价
企业协议(EDP / MCA)、承诺用量、预留实例、节省计划、竞价实例——你实付的价格,通常比公开目录价低,而且低得没有规律。
PingCloud 的选择是只收官方公开目录价,绝不估算。理由很硬:目录价是唯一跨厂商可比、可复现、可审计的口径。你的折扣是你谈判的结果,把它混进公共基准,所有人的数字都会失真。
二、Ping:一个数字藏着的四个陷阱
1. 平均、中位、P95、丢包——四个不同的真相
PingCloud 的新加坡榜单(3 天窗口,按中位时延排序):
| 排名 | 厂商 | 平均时延 | 中位时延 | 丢包 | 城市数 | 样本数 |
|---|---|---|---|---|---|---|
| 1 | 微软云 | 1.1 ms | 0.9 ms | 0.0% | 1 | 9 |
| 2 | 腾讯云 | 1.4 ms | 1.1 ms | 0.0% | 1 | 13 |
| 3 | 谷歌云 | 1.9 ms | 1.3 ms | 0.0% | 1 | 11 |
| 4 | 阿里云 | 1.3 ms | 1.3 ms | 0.6% | 1 | 11 |
注意第 3 和第 4 行:阿里云的平均值(1.3)比谷歌云(1.9)更好,中位数打平,但因为按中位排序,谷歌云排在了前面。
在这个量级上,1 毫秒的差异基本是噪声。更值得看的是右边三列——城市数 1、样本数 9-13。 这不是一份「新加坡全国」的数据,这是一条探针线路在几天里的十几次测量。
2. 丢包率,比时延更该被盯着
回到德国视角。$5.55 那一档里,华为云北京的平均 RTT 是 217.87 ms,丢包 3.59%;同一价格档的华为云上海是 247.76 ms,丢包 0%。
再看美国视角:华为云广州 217.82 ms,丢包 5.91%。
5.91% 的丢包意味着什么?在 TCP 上,它不是「慢 6%」,而是持续的重传、拥塞窗口反复减半、以及 HTTP/2 单连接上的队头阻塞。对 API 和交互式业务,5% 丢包的伤害通常大于多 20 ms 的时延。
一个只有平均 RTT 的表格,看不出这件事。
3. 「国家级聚合」不是你的用户
所有国家级数字都是聚合值:窗口内全部已测城市、全部探针,按测量次数加权。东京和伦敦相邻的两条家庭宽带,国际路由可能走完全不同的跨洋光纤。
所以 PingCloud 在给出每个平均值的同时,强制附上城市数、ASN 数、样本数、测量天数——以及一个置信度(高 / 中 / 低 / 不足)。
这一点在云服务器选型里非常实用:如果你看到某个区域的样本只有 3 个城市,就别拿它做预算决策。
4. 你测的是哪一跳?
同一个区域,三个工具给三个数,都「对」:
- 浏览器 HTTP PING:从你自己的网络发 HEAD 请求,含 DNS / TCP / TLS 握手,等于 TTFB
- 云 Ping 测试:从指定城市的独立探针发 ICMP,单次测量
- 排行榜 / 探索器:多天、多城市、每次 15 个 ICMP 包的加权聚合
三个数字回答三个不同的问题。用错口径做决策,比没有数据更危险——比如拿自己办公室的 Ping 值去论证东南亚用户的体验。
三、时延的边际成本,不是一条直线
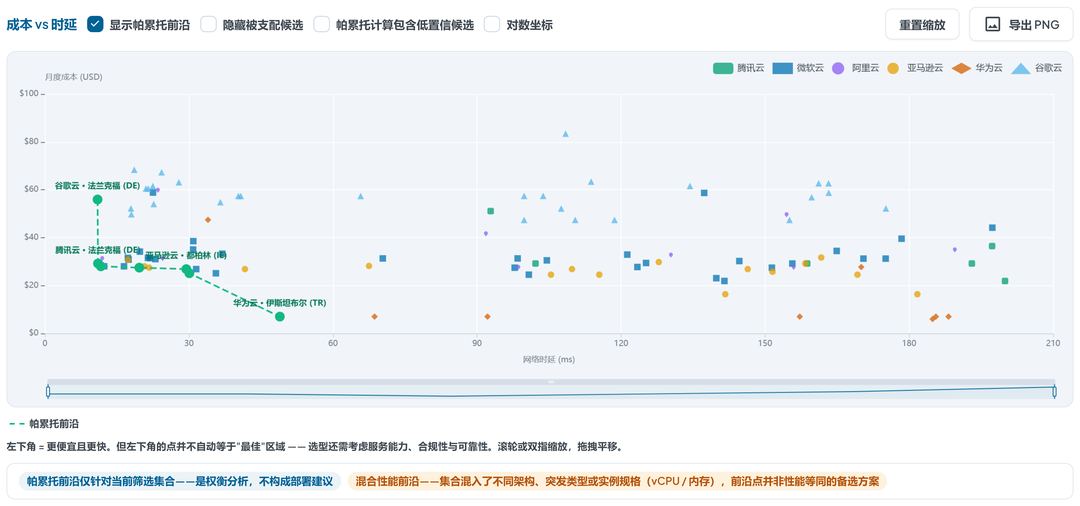
把德国用户的候选区域画在「月成本 × 时延」平面上:187 个候选里,帕累托前沿只剩 8 个点。(下图为了可读性把最大时延限制在 200 ms,显示 107 个候选,前沿形状一致。)
| 区域 | 月成本 | 平均 RTT | 相对上一点的边际成本 |
|---|---|---|---|
| 华为云 北京 | $5.55 | 217.9 ms | — |
| 华为云 伊斯坦布尔 | $7.01 | 48.9 ms | 多 $1.46,少 168.9 ms → $0.009 / ms |
| AWS 斯德哥尔摩 | $25.11 | 30.1 ms | 多 $18.10,少 18.9 ms → $0.96 / ms |
| AWS 都柏林 | $26.86 | 29.4 ms | 多 $1.75,少 0.6 ms → $2.74 / ms |
| AWS 巴黎 | $27.45 | 19.7 ms | 多 $0.58,少 9.8 ms → $0.06 / ms |
| AWS 法兰克福 | $28.03 | 11.6 ms | 多 $0.58,少 8.0 ms → $0.073 / ms |
| 腾讯云 法兰克福 | $29.20 | 11.1 ms | 多 $1.17,少 0.6 ms → $1.98 / ms |
| 谷歌云 法兰克福 | $55.95 | 11.0 ms | 多 $26.75,少 0.09 ms → $297 / ms |
这张表是全篇最重要的一页。
第一档($5.55 → $7.01):多花 1.46 美元,时延从 218 ms 降到 49 ms。每毫秒 0.9 美分。这是全世界最划算的一笔交易。
中间档:从 49 ms 到 11.6 ms,你要付 $21,每毫秒从 1 美分涨到 7 美分。还在合理区间。
最后一档:从腾讯云法兰克福换到谷歌云法兰克福,多付 $26.75,换 0.09 毫秒。每毫秒 297 美元,比前一档贵了 4000 倍。
没有任何业务该在这个位置做决策,除非那 0.09 ms 真的是你的商业模型本身。
四、地理:同一台机器,价格不动,体验差 2.3 倍
前面说「全球最低价 $5.55」,现在把来源国家换掉,价格纹丝不动,体验变了:
| 用户所在国 | 华为云 at7 系列($5.55 档)平均 RTT |
|---|---|
| 日本 | 155.9 ms |
| 德国 | 217.9 ms |
| 美国 | 217.8 ms(丢包 5.9%) |
| 新加坡 | 336.2 ms |
| 巴西 | 354.3 ms |
同一台机器、同一个价格,体验差 2.3 倍。它一点都不慢——它只是不在你的用户那一侧。
这也就是「最便宜的云区域,往往离你的用户最远」的全部证据。「最便宜」是一个绝对判断,而「离你用户多远」是一个相对判断,两者的坐标系根本不同。价格表按美元排序,用户却按经纬度分布。
而如果把视角切到新加坡,你会发现华为云新加坡($5.99)就在 2.09 ms——同样的价格带,本地命中。最低价和最优解是可以重合的,但前提是你先回答了「用户在哪」。
两个真实的反例,正好是一面镜子:
巴西:全场最快是腾讯云圣保罗 $43.80 / 22.16 ms;华为云圣保罗 $7.01 / 22.25 ms 就在旁边。6.2 倍价格,换 0.09 毫秒($408 / ms)。
日本:华为云香港 $5.99 / 67.40 ms,AWS 大阪 $31.75 / 12.97 ms。5.3 倍价格,5.2 倍时延——这是一笔公平交易。 如果东京是你的核心市场,那 $31.75 花得对。
同样是「便宜 vs 快」,一个不值得买,一个值得买。区别不在价格,在你对那 50 毫秒的业务定义。
五、帕累托:把二维决策压成一条曲线
成本与时延的选择,本质是多目标优化。
候选 A 支配候选 B,当且仅当:A 的成本 ≤ B 且 A 的时延 ≤ B,并且至少有一项严格更优。
前沿 = 所有没被别人支配的点。 被支配的候选,探索器会直接告诉你是被哪一个厂商的哪个区域支配的——就这一步,德国视角的 187 个候选里,最后只剩 8 个值得讨论。
但请记住三件事:
- 前沿不是推荐。 它只处理两个目标。合规(GDPR、数据驻留、等保)、服务成熟度、区域 SLA、你依赖的托管服务在这个区有没有、可用区数量、跨区流量费——全都不在图里。
- 混合性能的前沿不可比。 把突发型和独享型混在一个筛选里,前沿点之间的权衡没有意义。
- 低置信度候选默认不进前沿。 样本太少的不参与排名,但保留在结果里,标出来。
PingCloud 在界面里把这三点都写在了图下面,而不是藏进文档。一个基准工具最重要的品质,是知道自己的结论到哪里为止。
六、PingCloud 的三条铁律
研究这个站的时候,真正打动我的不是功能数量,是它为了「可比」愿意放弃多少东西。
铁律一:测真实用户网络,不测机房到机房
测量跑在 Globalping 的志愿探针网络上:1,053 个活跃探针城市、113 个国家、约 4,900 个可用探针,藏在真实的家庭、企业和 ISP 网络里。
更关键的一步:把托管在 7 家被评测云厂商自有网络上的探针全部剔除。
原因写在帮助中心里,非常实在——排除之前,云厂商探针决定了 7 天榜里 8 个国家的第一名。韩国春川的探针全部位于 Oracle 网络上,让 Oracle 的区域测出 10.0 ms,排在从独立网络测得的 Azure 首尔 11.9 ms 之前。那 10 ms 是厂商骨干网的特权内部路径,真实用户永远走不到。
任何厂商都不能给自己打分。 这句话听起来像常识,但要在数据层面执行到「每条测量线路都固定到独立 ASN、漏网结果入库时拒绝」,是工程量。
铁律二:只用官方价格,绝不估算
7 家厂商分别对接官方来源:AWS Bulk Price List API、Azure Retail Prices API、GCP Cloud Billing Catalog、阿里云价格计算器 productInfo、腾讯云 CVM 网关、华为云计算器 + BSS 交叉验证、OCI 成本估算器。每周同步,超过 7 天打新鲜度标记。
目前收录 192,466 个云服务器 SKU、2,708 个云硬盘 SKU。
而「不估算」这条,是往回收的:
- 华为云的竞价价只在登录后的控制台可见,公开 API 不发布 → 不做,不拿按量价冒充
- Oracle GPU 的估算器只按单块 GPU 部件计价,拆不出 CPU / 内存 → 不收录
- 包级 P95 需要逐包原始时延,系统没存 → 不估算,只给测量级 P95
- 内存 / 性能附加费未被价格源公开的盘类型 → 永远标「部分成本」,缺失金额如实写「未包含」
一个数据产品最难的不是加功能,是在缺数据的时候选择留白而不是填坑。因为填出来的坑,最后都变成别人服务器上的事故。
铁律三:同一探针、同一参数、同一时间
每个测试周期,同一个探针以完全相同的参数测量所有厂商的所有区域。每次测量 15 个 ICMP 包,中位数直接由原始样本计算(不用预聚合值),跨城市严格按样本数加权,窗口丢包 > 50% 的城市直接剔除。
跨厂商对比的公平性不是声明出来的,是被这个流水线结构保证的。
还有一条隐含的:全部免费开放。免 API Key 的 REST 接口(每 IP 每分钟 60 次)、每日更新的静态 JSON、永久保留的月度归档,学术引用注明出处即可。
它要的是公共基准,不是销售线索。

这张卡片是我认为全站最有说服力的一屏:187 个候选、最低时延 11.0 ms(谷歌云法兰克福)、最低月成本 $5.55(华为云上海)、帕累托候选 8 个。
一句话说完了整个选型问题的结构:三个「最优」是三个不同的地方。
七、云服务器选型,可以照着跑的五步
- 先把「全球用户」拆成具体的地理分布。 用你的埋点数据,不用直觉。这一步决定了后面所有计算的分母。
- 用性能基准缩候选。 按国家看加权中位时延的前 10-20 个区域,把那 233 个先砍到可讨论的规模。
- 固定规格再看前沿。 在探索器里锁死 vCPU / 内存 / 架构 / CPU 性能模型,否则你比的是苹果和橘子。
- 在前沿上算边际成本。 每省 1 ms 花多少钱?这个数掉到你的收益区之外时,就停手。
- 验证实时路由。 对等互联会变。用云 Ping 测试从目标城市实测一次,再用真实业务压测确认。
- 最后用硬约束剪枝。 合规、服务清单、SLA、可用区、迁移成本——不合规的区域,再快再便宜也不存在。
顺序很重要:先剪枝,再优化。 反了就是白算。
最后
所以「最便宜的云区域,往往离你的用户最远」不是一句俏皮话。它是价格表的必然结果——因为价格表里没有「用户」这一列。
而你真正要回答的是:对我的用户来说,哪个区域在可接受的体验下最便宜。
这两个问题差了一个维度:用户在哪。一个维度的表格,永远算不出两个维度的答案。
自己试一遍: pingcloud.io/zh → 成本与时延探索器 → 选来源国家、填规格。免登录、免注册。 方法论与开放 API:pingcloud.io/zh/help